TRT World Dijital Ekip Sorumlusu Abdulvehab Ejupi, kısa süre önce kullanıma açılan milli yapay zeka platformu EVREN’in Türkiye’nin yapay zeka alanındaki altyapı ve egemenlik hedefleri açısından taşıdığı önemi değerlendirdi.
EVREN ortak yapay zeka altyapısı sunuyor
EVREN’i Türkiye’nin ChatGPT’si olarak tanımlamak yerine, yapay zeka geliştirme sürecinin farklı aşamalarını ortak bir altyapıda birleştiren bir platform olarak ele almak gerekiyor. Savunma Sanayii Başkanlığı bünyesinde geliştirilen sistem; veri hazırlama ve etiketleme, model eğitimi, bilgisayarlı görü uygulamaları ve büyük dil modellerinin çalıştırılması gibi süreçleri kapsıyor.
Platformda 11 açık ağırlıklı büyük dil modeline erişim sağlanıyor. Kullanıcılar veri seti yükleyerek, veri etiketleyerek veya eğittikleri modelleri paylaşarak kredi kazanabiliyor; bu krediler yüksek performanslı Grafik İşlem Birimi altyapısında model eğitimi ve çıkarım işlemleri için kullanılabiliyor.
EVREN’in hesaplama altyapısında her biri 141 gigabayt HBM3e belleğe sahip 64 Nvidia H200 GPU bulunuyor. Sistem yaklaşık 9 terabayt yüksek bant genişlikli GPU belleği ve 47,5 petaflop FP16 Tensor Core hesaplama kapasitesi sunuyor.
Platform kısa sürede yaklaşık 15 bin aktif kullanıcıya ulaştı. Önümüzdeki aşamada yerli büyük dil, görüntü ve ses modellerinin sisteme eklenmesi ile dağıtık GPU altyapısının geliştirilmesi planlanıyor. Bu kapasitenin özellikle üniversiteler, araştırmacılar ve teknoloji girişimleri için hesaplama gücüne erişim imkanı sağlaması hedefleniyor.
Veri ve hesaplama gücü stratejik unsurlara dönüşüyor
Yapay zeka çağında rekabet yalnızca en büyük modeli geliştirme kapasitesiyle ölçülmüyor. Enerji, veri merkezleri, hesaplama kapasitesi, veri ve nitelikli insan kaynağı da ülkelerin yapay zeka alanındaki gücünü belirleyen unsurlar arasında yer alıyor.
EVREN’in öne çıkan yönlerinden biri veri egemenliği hedefi. Kullanıcı istemlerinin, yanıtların ve kullanım verilerinin Türkiye’de bulunan yüksek performanslı GPU altyapısında işlenmesi amaçlanıyor. Bu yaklaşım, özellikle savunma, kamu ve kritik sektörlerde verinin yanı sıra yapay zeka işleminin nerede gerçekleştirildiği ve hesaplama altyapısının kim tarafından kontrol edildiği sorularını gündeme getiriyor.
Yapay zeka egemenliği; veri, model ve hesaplama gücü olmak üzere üç temel unsur üzerinden şekilleniyor. Bu çerçevede teknolojik egemenlik, her çipin, modelin ve yazılımın ülke içinde üretilmesinden çok kritik teknolojilerde stratejik hareket alanı oluşturabilme kapasitesiyle değerlendiriliyor.
Yapay Zeka Eylem Planı hedefleri
EVREN, Türkiye Yapay Zeka Eylem Planı’ndan bağımsız bir girişim olarak değerlendirilmiyor. Haziran ayında kamuoyuna açıklanan ve 18 Ağustos 2026’da yürürlüğe giren 2026-2030 dönemine ilişkin plan, "Fark Et, İstifade Et, Üret ve Yönet" başlıkları altında dört yıllık bir yol haritası ortaya koyuyor.
Plan kapsamında 2030’a kadar en az 1 gigavat yapay zeka ve veri merkezi kapasitesine ulaşılması, ağırlıklı olarak özel sektörden en az 10 milyar dolarlık yatırım çekilmesi, 10 bin ileri düzey yapay zeka uzmanı ve 100 bin yapay zeka uygulama profesyoneli yetiştirilmesi hedefleniyor. Ayrıca iki yıl içinde 5 milyon kişinin yapay zeka okuryazarlığı programlarına dahil edilmesi planlanıyor.
Araştırmacılar, girişimler ve küçük ve orta büyüklükteki işletmeler için "Herkes İçin GPU" programı, Ulusal Veri Kütüphanesi, sektörel yapay zeka modelleri ile fiziksel yapay zeka ve robotik kapasitesinin geliştirilmesi de planın unsurları arasında bulunuyor.
Enerji ve veri merkezi kapasitesi belirleyici olacak
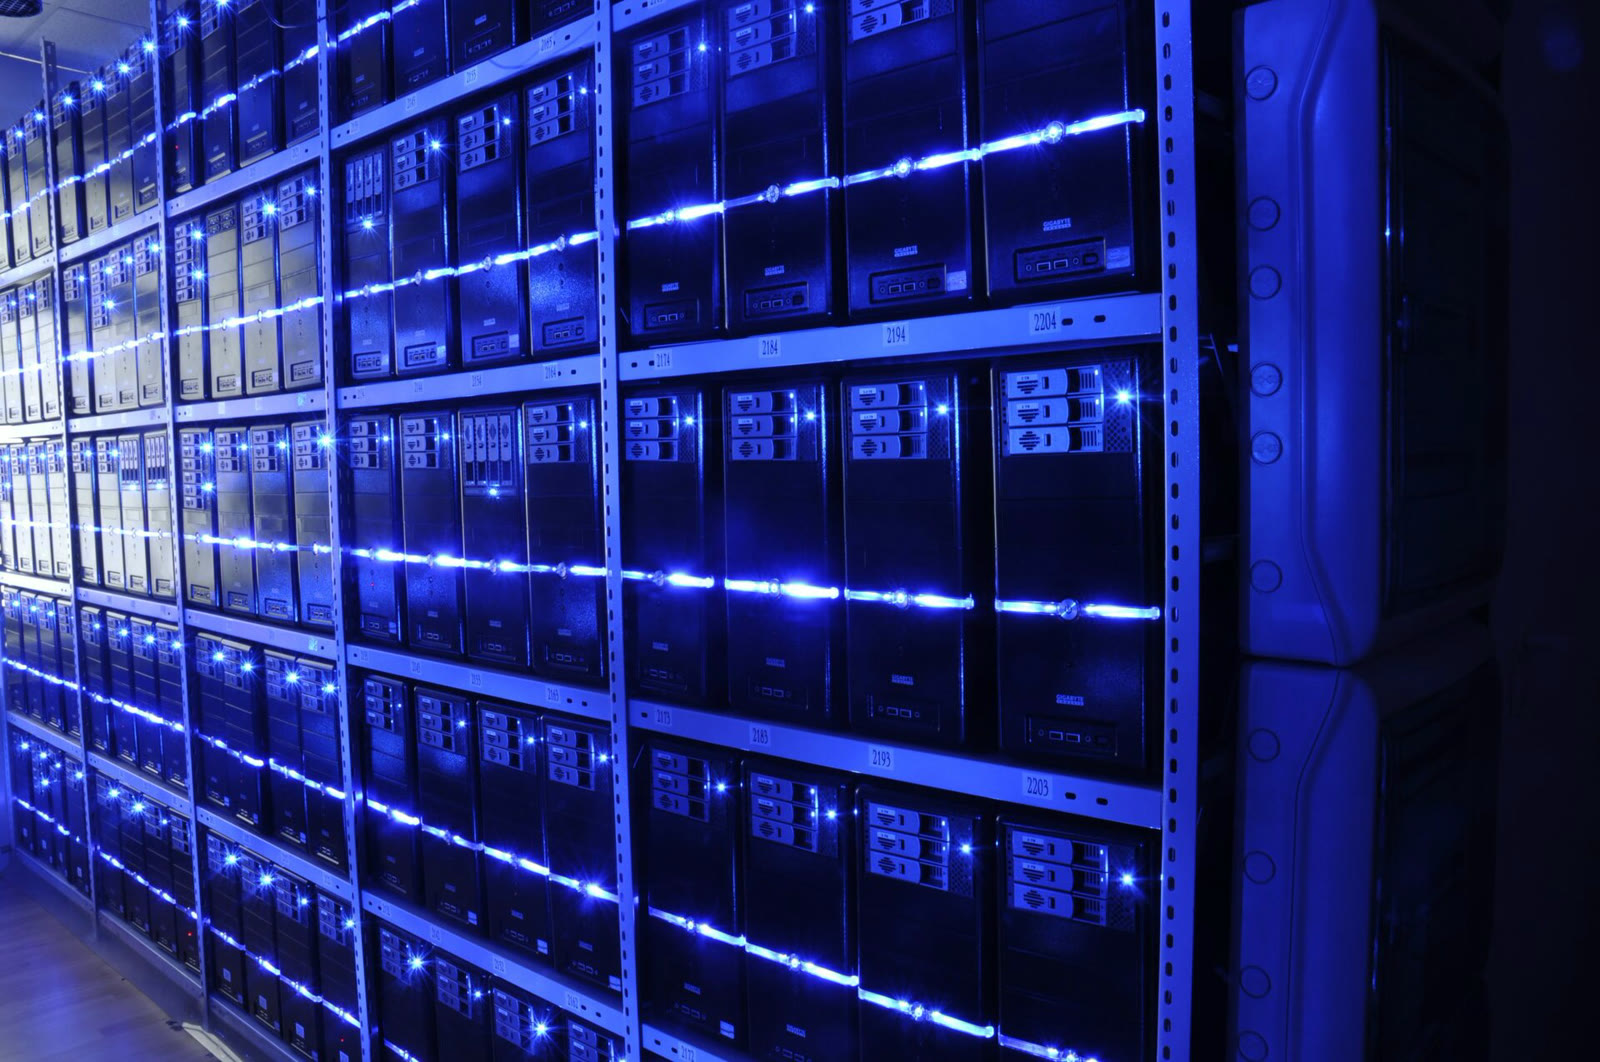
Yapay zeka altyapısı yalnızca yazılım ve çiplerden oluşmuyor. Büyük veri merkezleri kesintisiz elektrik, güçlü şebekeler, soğutma sistemleri ve fiber bağlantılar gerektiriyor. Bu nedenle Türkiye’nin 1 gigavatlık veri merkezi hedefinin gerçekleşmesi, enerji ve fiziksel altyapı yatırımlarına bağlı olacak.
Türkiye’nin enerji koridoru rolü, elektrik iletim projeleri, yenilenebilir enerji yatırımları ve Akkuyu ile devreye alınması planlanan nükleer kapasiteyle birlikte yapay zeka altyapısı açısından da değerlendiriliyor. Türkiye’nin Avrupa ile Asya arasında enerji ve hesaplama koridoruna dönüşmesi ise mevcut durumda bir hedef ve olasılık olarak ele alınıyor.
Uzmanlaşma ve sonuç ölçütleri
Türkiye’nin OpenAI, Google DeepMind veya Anthropic ölçeğinde yüz milyarlarca dolarlık genel amaçlı model yarışını taklit etmesi gerekmiyor. Savunma ve otonom sistemler, endüstriyel yapay zeka ve robotik, enerji, lojistik, tarım teknolojileri ile Türkçe ve bölgesel dillere yönelik modeller, uzmanlaşma alanları arasında gösteriliyor.
EVREN’in hesaplama altyapısında Nvidia H200 GPU’lar bulunuyor ve platformdaki büyük dil modellerinin önemli bölümü küresel açık ağırlıklı modellerden oluşuyor. Buna karşın platformun önemi, Türkiye’nin veriyi ülke içinde tutabilmesi, modelleri kendi altyapısında çalıştırabilmesi ve araştırmacıların hesaplama gücüne erişimini artırabilmesi üzerinden değerlendiriliyor.
Platformun kurulması ile küresel ölçekte rekabetçi bir yapay zeka ekosistemi oluşturulması aynı sonucu ifade etmiyor. EVREN’in başarısının ilerleyen yıllarda kullanıcı sayısından çok geliştirilen yerli modeller, ortaya çıkan girişim ürünleri, ticarileşen araştırmalar ve savunma alanındaki teknolojilerin sivil ekonomiye aktarımıyla ölçülmesi bekleniyor.
Bu yaklaşımın nihai hedefi ABD veya Çin’i yapay zeka yarışında geçmekten çok Avrupa, Körfez, Balkanlar, Kafkasya ve Orta Asya’nın kesişiminde yapay zeka üretim, hesaplama ve uygulama merkezi oluşturmak olarak öne çıkıyor. EVREN’in bu hedefe katkısı; özel sektör ve üniversiteler tarafından etkin kullanılması, enerji ve veri merkezi yatırımlarıyla desteklenmesi ve insan kaynağının güçlendirilmesine bağlı olacak.