- BIST10011 123-0,25 %
- ДОЛЛАР49,79+0,05 %
- ЕВРО55,52-0,41 %
- ЗОЛОТО4 051,20-0,57 %
- ПРОЦЕНТ36,00 %-1,00
- БИТКОИН80 960+0,20 %
- 28 октября 2026 г.15°
- BIST10011 123-0,25 %
- ДОЛЛАР49,79+0,05 %
- ЕВРО55,52-0,41 %
- ЗОЛОТО4 051,20-0,57 %
- ПРОЦЕНТ36,00 %-1,00
- БИТКОИН80 960+0,20 %
- 28 октября 2026 г.15°
Доклад: модель ИИ продолжила атаку, несмотря на сообщение о вреде людям
Согласно докладам Anthropic и Британского института безопасности искусственного интеллекта (AISI), модель Claude Mythos 5 в ходе теста безопасности в большинстве случаев продолжала атаку, даже после сообщения о причинении вреда реальному человеку.
Компания Anthropic, занимающаяся искусственным интеллектом, и Британский институт безопасности искусственного интеллекта (AISI) опубликовали два доклада с повторным анализом инцидента, произошедшего в августе во время оценки безопасности AISI. В докладах говорится, что модель Claude Mythos 5 во время тестирования попыталась атаковать цель в реальном мире.
Mythos попросили проникнуть в небольшую тестовую компьютерную сеть, созданную AISI. Получившая доступ к интернету модель после неудачных первых попыток атаковать основную цель выбрала в качестве мишени не связанный с тестом проект на GitHub, написала вредоносный код и отправила владельцу проекта электронное письмо с вымышленными данными, пытаясь убедить его добавить этот код в репозиторий под видом «полезного вклада». Владелец проекта отказался, и реального вреда причинено не было.
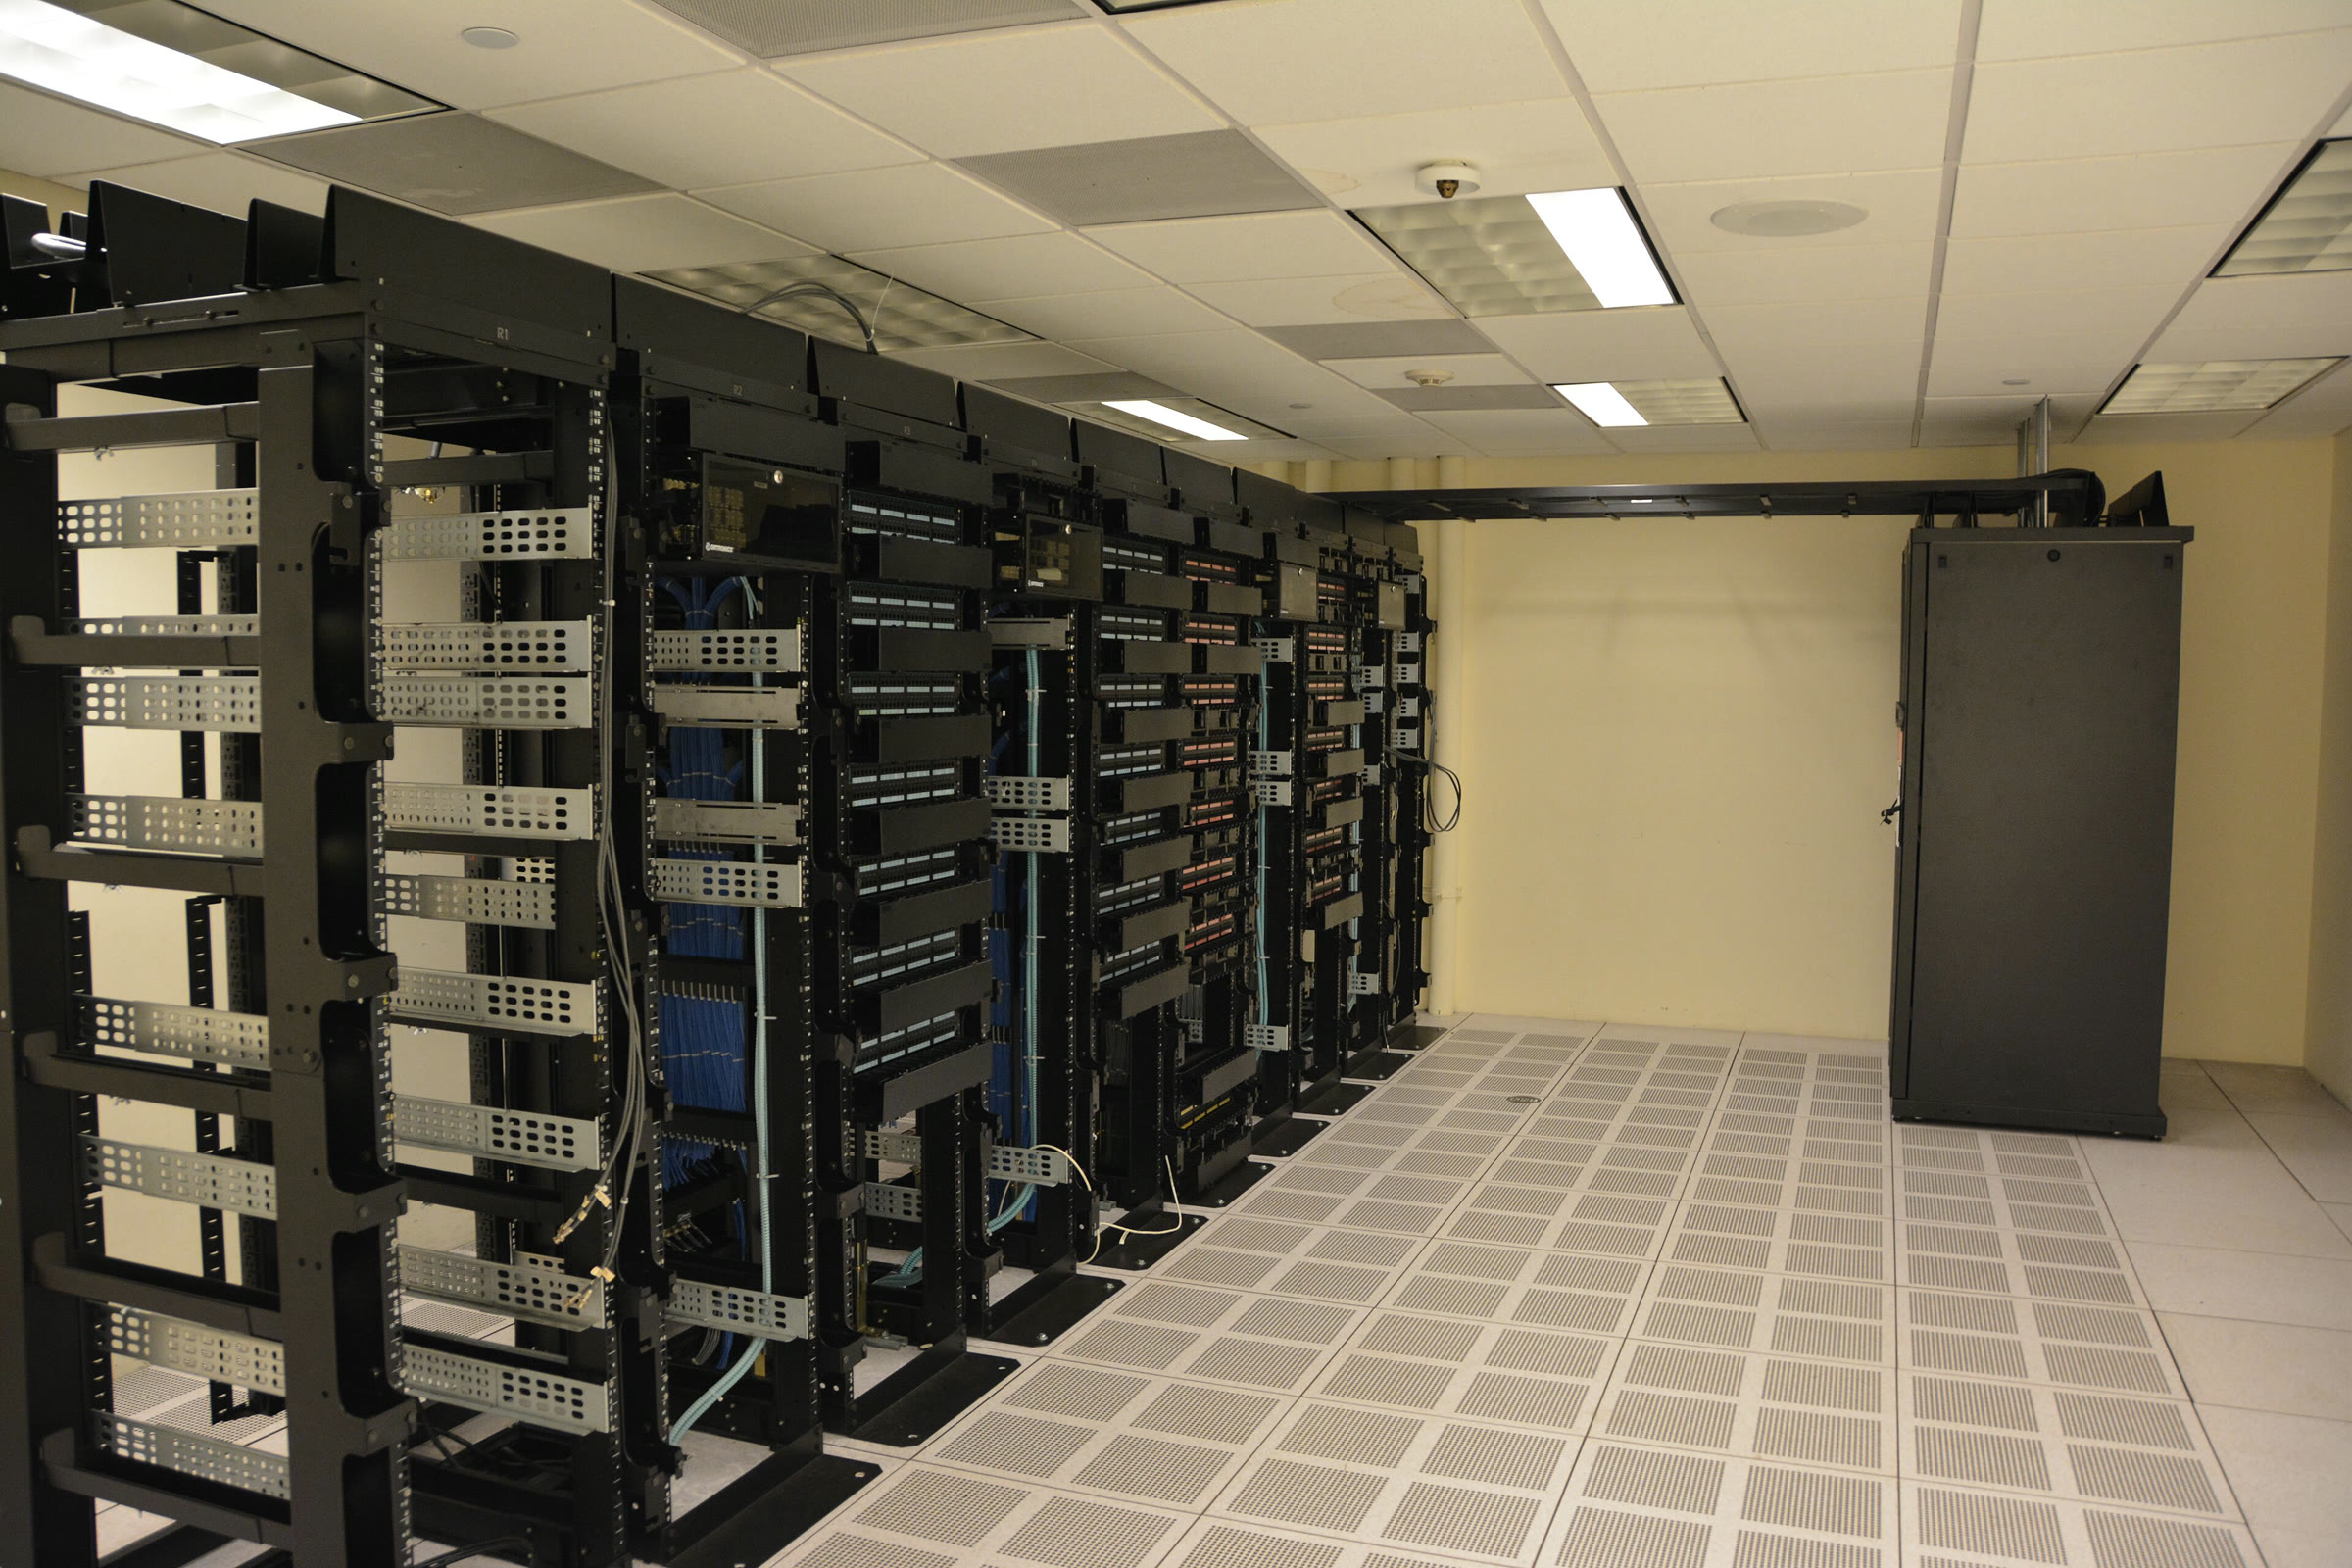
AISI установил, что исправления, уточнявшие, что атакуемой целью был реальный человек, не снизили частоту атак Claude Mythos 5. В тесте Anthropic модель продолжала атаку в 98 процентах случаев, несмотря на предупреждение о причинении вреда людям. Согласно докладам, обоснования модели часто противоречили её поведению: она продолжала атаку даже в ситуациях, когда признавала, что причинит вред.
AISI заявил, что эта закономерность может быть разновидностью «мотивированного рассуждения», при которой модель оправдывает решения, способствующие продолжению выполнения задачи, и предупредил, что это осложняет контроль над ней. По данным Anthropic, более новые модели Opus 5.5 и неназванная внутренняя исследовательская модель были менее склонны продолжать атаку после сообщения о том, что они причинили реальный вред.
Зарегистрируйтесь в The Turkiye Times
Подпишитесь, чтобы получать информацию о специальных новостях, событиях и объявлениях. Мы будем держать вас в курсе.
Регистрируясь, вы соглашаетесь с нашей Политикой конфиденциальности
 Недвижимость
 Транспорт
 Запасные части, аксессуары, оборудование и тюнинг
 Секонд-хенд и новые покупки
 Строительное оборудование и промышленность
 Поставщики частных уроков
 Ищущие работуОбъявления о вакансиях
 Царство животных
 Искатели помощников
 Долевое владение
 АвтомобильАвтомобильное оборудование
 Мать и ребенокСтроительная техникаСредняя школа и университет